Krasper Bragi
Eine KI-Trainingsplattform, die Kundengespräche per Sprache simuliert, mit 3D-Avatar und kalibrierter Bewertung.
Ein Flugsimulator für Kundengespräche. Mitarbeiter üben mit KI-Personas, die sich wie echte Kunden verhalten, zu jeder Zeit, ohne Trainer, Rollenspielpartner oder Terminkoordination.
Kernfunktionen
Charaktere, die echte Kunden spielen, vom Anrufer mit defekter Wärmepumpe bis zur Eskalation, die bereits laut beginnt. Archetypen und Schwierigkeitsgrade liegen in der Datenbank, nicht handgeschrieben im Prompt.
Personas antworten aus Ihren eigenen Produktinformationen und Troubleshooting-Schritten. Wissensgruppen sind mit Szenarien verknüpft und werden zur Laufzeit in den Persona-Kontext injiziert.
Ein gesprochenes Gespräch über WebSocket mit Voice Activity Detection. Deepgram, ElevenLabs und OpenAI Realtime sind als Sprach-Provider austauschbar, mit automatischem Failover.
Ein animierter Gesprächspartner mit Lippensynchronisation, angetrieben von NVIDIA-Audio2Face-3D-Blendshapes aus dem Audiostream, mit Emotion-Mapping von ruhig über verwirrt bis verärgert.
Jede Session wird über Dimensionen wie Empathie, Lösungsorientierung und Fallabschluss bewertet, gegen Rubrics, die ein Administrator bearbeitet, klont und versioniert.
Referenzgespräche verankern die Bewertung. Regressionsläufe prüfen, ob eine neue Prompt-Version dieselben Transkripte weiterhin gleich bewertet, Kalibrierungsreports zeigen Übereinstimmung und Trends.
Trainer übernehmen eine Evaluierung, bestätigen, korrigieren oder verwerfen sie und heben starke Gespräche in den Golden-Datensatz. Jede Entscheidung bleibt zuordenbar.
Sequenzierte Szenarien mit Mindestpunktzahl je Schritt, zugewiesen an Personen oder Teams, mit Fortschritt je Schritt und Zuweisungen, die pausiert und fortgesetzt werden können.
XP, einhundert Level, Badges, wöchentliche, monatliche und All-Time-Leaderboards sowie tägliche Streaks, alle aus abgeschlossenen Sessions berechnet, nicht aus Selbstauskunft.
Zum Abschluss eines Pfads wird ein PDF-Zertifikat mit Gesamtscore und Zertifikatsnummer ausgestellt, mit öffentlicher Verifikationsseite und Widerruf durch Administratoren.
PII-Erkennung und -Schwärzung, Prompt-Injection-Erkennung in sieben Kategorien, Toxicity-Filterung und Token-Budgets je Session, angewendet vor und nach jedem Modellaufruf.
Performance-Übersichten, Trends, Dimensionsanalyse und häufige Problemmuster je Team, unter rollenbasierter Zugriffskontrolle mit 61 einzelnen Berechtigungen und eigener Verwaltungsoberfläche.
Unternehmensinfrastruktur abzusichern?
Vereinbaren Sie ein technisches Briefing. Kein Sales-Pitch, nur Architekten und Ihr Team.
Jedes Gespräch auf denselben Dimensionen bewertet
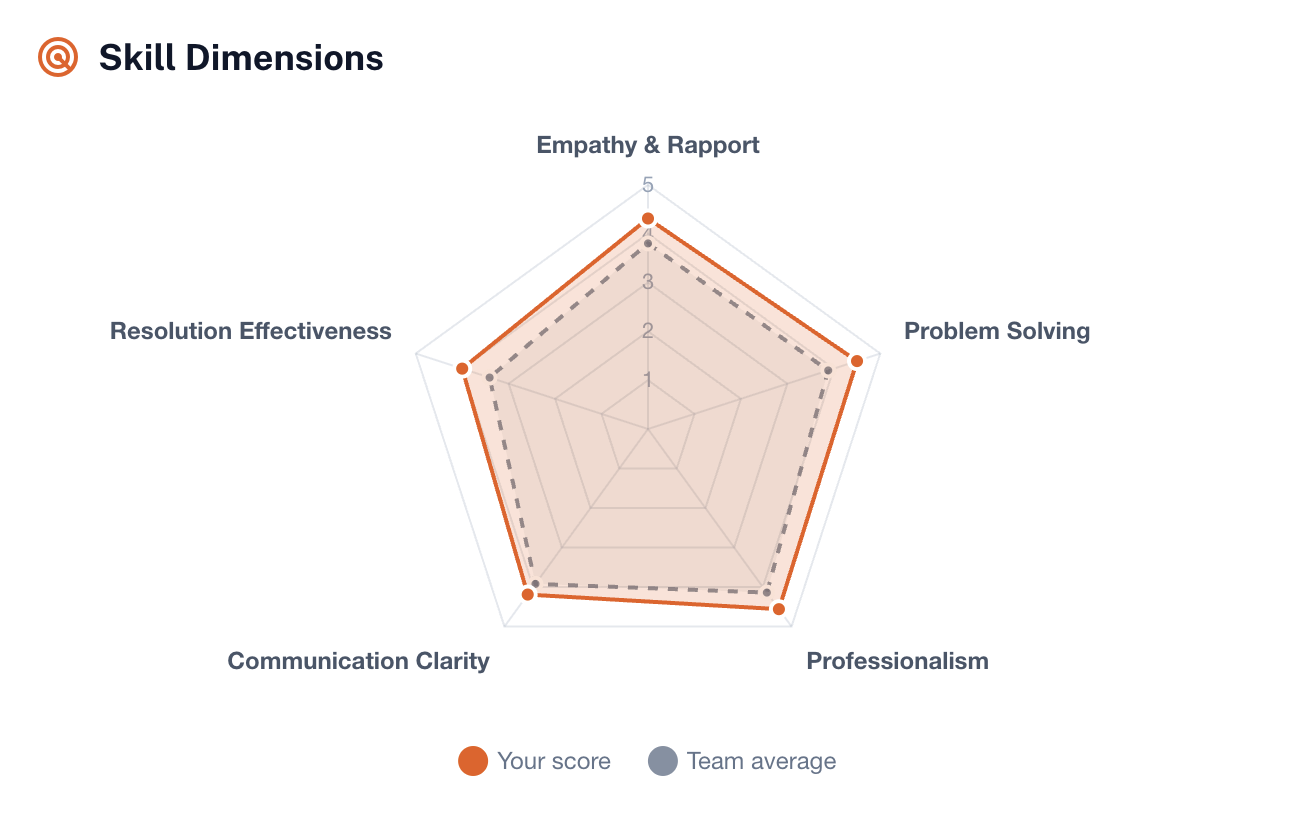
Nach der Session zerlegt die Auswertung das Gespräch in Kompetenzdimensionen: Empathie, Lösungsorientierung, Professionalität, Klarheit der Kommunikation und Fallabschluss. Der eigene Wert steht neben dem Teamdurchschnitt, damit eine Lücke sichtbar ist, bevor sie jemand formulieren muss.
Strukturierte Übung statt zufälligem Rollenspiel
Ein Pfad sequenziert Szenarien und setzt je Schritt eine Mindestpunktzahl. Weitergehen darf, wer den Schritt besteht, nicht wer ihn versucht.
Ein Pfad in Bearbeitung
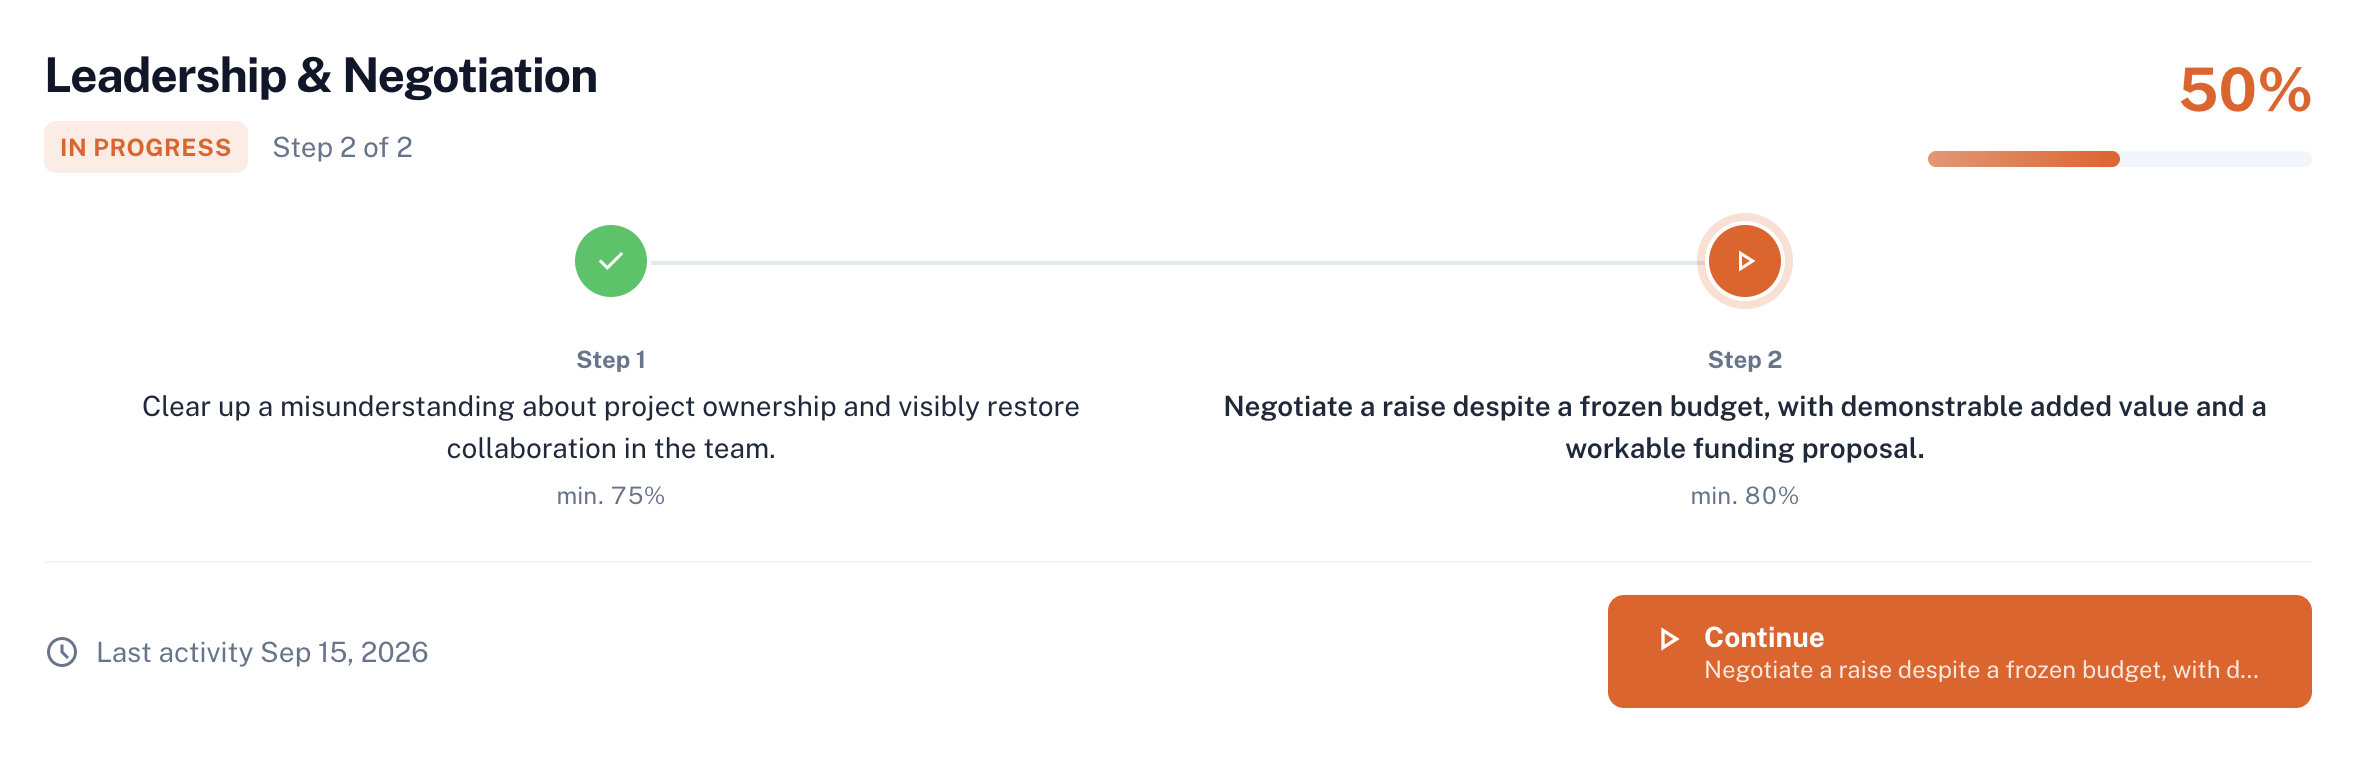
Führung und Verhandlung, Schritt zwei von zwei. Der erste Schritt, ein Missverständnis über Projektverantwortung aufklären und die Zusammenarbeit wiederherstellen, besteht ab 75 Prozent. Der zweite, eine Gehaltserhöhung gegen ein eingefrorenes Budget verhandeln, verlangt 80 Prozent.
Fortschritt, den man sieht
XP, Level, Badges und Leaderboards werden aus abgeschlossenen und bewerteten Sessions berechnet. Anerkennung folgt damit der Übung, nicht der Anwesenheit.
Auszeichnungen und was als Nächstes erreichbar ist
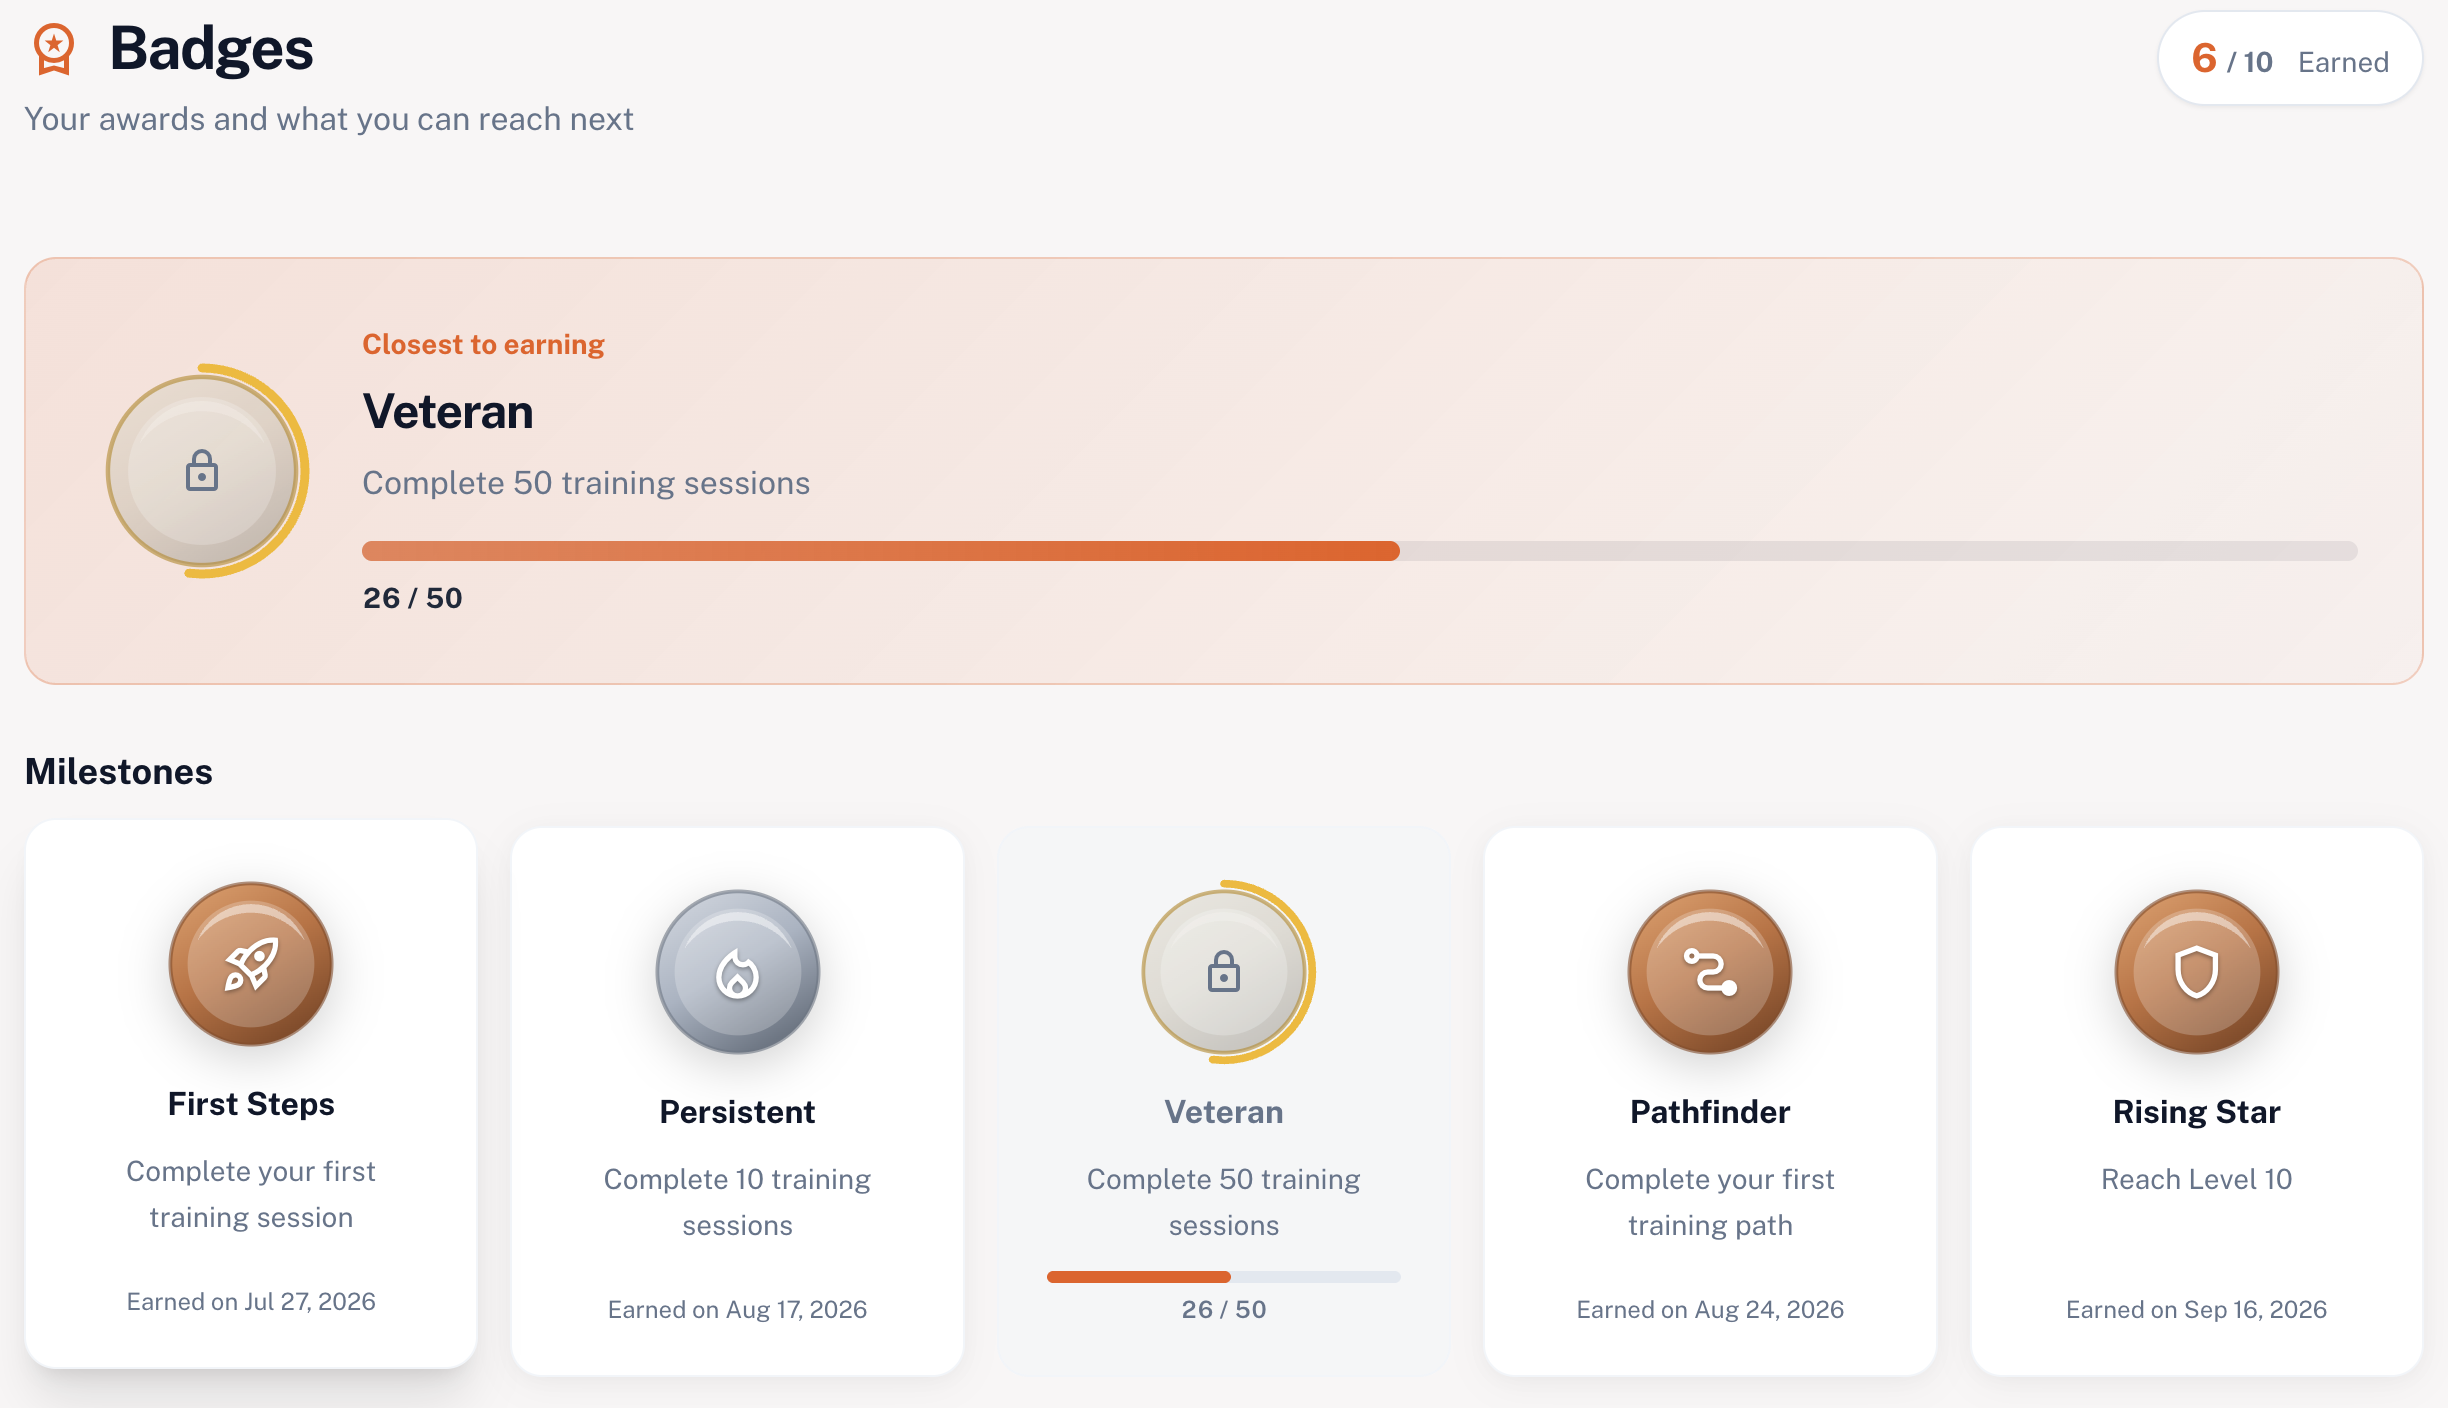
Meilenstein-, Streak-, Skill- und Sonder-Badges werden automatisch vergeben. Das nächstgelegene noch offene Badge steht mit der verbleibenden Distanz oben, hier 26 von 50 Trainingssessions bis Veteran.
Ein Nachweis, der die Plattform verlässt
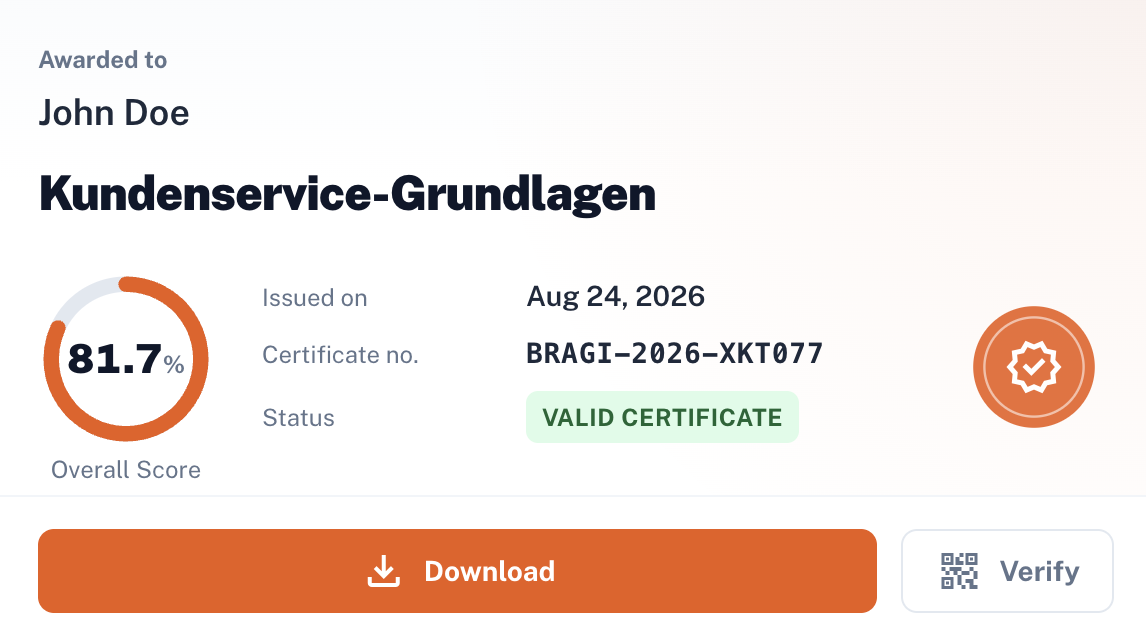
Der Abschluss eines Pfads stellt ein PDF-Zertifikat mit Gesamtscore, Ausstellungsdatum und Zertifikatsnummer aus. Die Verifikationsseite ist öffentlich, das Zertifikat lässt sich also auch ohne Konto prüfen.
Ihre Trainingsdaten bleiben, wo Sie sie ablegen. Bragi läuft self-hosted oder als betreuter Dienst. Provider-Zugangsdaten sind verschlüsselt gespeichert, die Guardrails erkennen und schwärzen personenbezogene Daten vor und nach jedem Modellaufruf, und lokale Modelle über Ollama halten den Modell-Traffic im eigenen Netz. Aufbewahrungsfristen, Provider-Wahl und Deployment-Ort werden im Scoping vereinbart.
Überall dort, wo Gesprächsqualität das Produkt ist
Support-Teams, die Eskalationen, Beschwerden und Übergaben üben, bevor sie ihnen auf einer echten Leitung begegnen.
Sales-Teams, die Bedarfsanalyse, Einwandbehandlung und Verhandlung gegen ein Gegenüber üben, das es ihnen nicht leicht macht.
Telefon-Agenten, die entlang eines Szenarien-Katalogs eingearbeitet werden, mit gemessenem Score vor dem ersten echten Anruf.
Techniker, die einen Anrufer durch die Fehlersuche führen, auf Basis Ihrer eigenen Produktdokumentation statt eines generischen Skripts.
Fragen zu Krasper Bragi
Was ist Krasper Bragi?
Krasper Bragi ist eine KI-Trainingsplattform für Kundengespräche. Mitarbeiter sprechen mit KI-Personas, die sich wie echte Kunden verhalten, und jede Session wird nach einer kalibrierten Rubric bewertet. Übung ergibt damit ein messbares Ergebnis statt eines Eindrucks.
Wie läuft eine Trainingssession ab?
Ein Mitarbeiter wählt ein Szenario oder den nächsten Schritt eines zugewiesenen Trainingspfads und spricht mit der Persona im Browser. Am Ende des Gesprächs wird die Session bewertet, mit Feedback je Kompetenzdimension gegen den Teamdurchschnitt; die iOS-App zeigt dieselben Evaluierungen, Pfade und Fortschritte. Der Abschluss eines Pfads stellt ein Zertifikat mit öffentlicher Verifikationsseite aus.
Ersetzt das menschliche Trainer?
Nein. Es nimmt den Rollenspielpartner aus der Schleife, damit Trainer ihre Zeit in der Review-Queue und bei den Fällen verbringen, die die Bewertung markiert, statt das zwanzigste Gespräch des Tages zu spielen.
Wie bleibt die Bewertung konsistent?
Rubrics sind versioniert, Golden Samples verankern die erwartete Note, und Regressionsläufe vergleichen eine neue Prompt-Version gegen diese Referenzen, bevor sie live geht. Abweichungen zwischen Bewertung und menschlichen Reviewern werden als Übereinstimmungsmetrik ausgewiesen.
Läuft das ohne Datenübertragung an externe Anbieter?
Ja, mit lokalen Modellen über Ollama in einem self-hosted Deployment. Die Sprach-Provider sind standardmäßig extern, ein vollständig isolierter Voice-Betrieb wird gesondert geplant.
Welche Sprachen werden unterstützt?
Die Plattform ist durchgängig auf Deutsch und Englisch verfügbar, einschließlich Bewertungsfeedback und Zertifikaten.